RTX 5060 Ti(16GB)でのローカルAI推論の実測検証が相次いでいます。8Bモデルを76トークン/秒で安定動作し、30人同時でもエラーゼロ。一方で30Bクラスは1枚では動かず、新モデル18個の比較でも既存モデルを超えたものはなかったと報告されています。
RTX 5060 Ti(16GB)でのローカルAI推論の実測検証が相次いでいます。8Bモデルを76トークン/秒で安定動作し、30人同時でもエラーゼロ。一方で30Bクラスは1枚では動かず、新モデル18個の比較でも既存モデルを超えたものはなかったと報告されています。
Liquid AIのMoEモデルLFM2.5-24B-A2BがGGUFで公開され話題に。公式はエージェント評価LiveClawで48.09とQwen3.6-35B-A3B超えを主張する一方、Redditでは実行環境次第でループや低品質の報告も。コミュニティ計測は平均61.2トークン/秒・品質69.6で、コーディング37.3という弱点も見えました。
llama.cppでAMD Radeon AI PRO R9700の推論を速める試行が話題です。処理量とグラフィックス処理系の設定見直しで、Qwen3 122Bが15トークン/秒から48トークン/秒に向上しました。一方で特定の設定帯で速度が崩れる落とし穴も見つかり、実測の大切さが浮かぶ内容です。
RTX 3090向けの無料高速化ハックがコミュニティで検証され、プロンプト処理22〜30%向上などの結果が報告されました。別の開発者は推論最適化で27Bモデルの生成速度を82から382 tok/sへ約4.6倍に引き上げています。検証内容と反応を追いました。
コーディングエージェント向け新モデル「Recursive Flint」(40B中2.5Bが稼働)が公開され、TerminalBench 2.1とSWE-bench Pro v2でQwen3.6-35B-A3Bを上回ったと話題です。ただし初期報告では、このクラスの標準は依然Ornith-1.5のままのようです。
AIモデルに「考える時間の予算」を自分で設定できる——Qwen3の技術報告が、そんな使い方を提示しています。前回は推論トークンを減らして効率を上げる動きを追いました。今回はその延長線上にある「1つのモデルで役割をまとめる」という流れを追います。Qwen3は、Qwenシリーズ最新バージョンの技術報告と […]
「モデルの中身を変えずに、生成を3倍以上速める。」そんな手法の最新版「EAGLE-4」が公開され、ローカルLLMコミュニティで話題になっています[1]。EAGLE-4は、EAGLEファミリーの最新世代です[2]。正式名称は「Extrapolation Algorithm for Greater La […]
Macノート1台で、270億パラメータ級のAIモデルが毎秒65トークンで動きました。こんな実測報告が、ローカルLLMコミュニティで話題になっています。舞台は最新フラッグシップではなく、数年前のMacです。前回の記事では、Qwen3.8 27BをSSDから読み出す推論と、精度回復の工夫を追いました。そ […]
Qwen3.8 Flash Nextを巡り、速度と精度を両立させる工夫が話題です。ローカルでは27BモデルがGPU2枚で約60tok/s、ベンチでは53tok/sという報告があります。評価データの欠落もあり、数字の背景にある条件が結果を左右します。
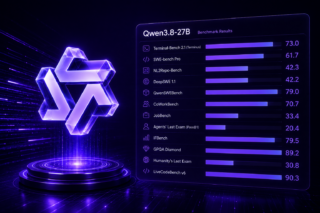
Qwen3.8 27Bはツールを使う推論に強く、広い知識では最上位モデルに届きません。ローカルでは2枚のP100で約60tps、Cerebrasでは1500 tok/sの報告があります。量子化と推論設定の読み分けが、ローカル利用の分かれ目です。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS