Hobは、ChatGPTやClaudeのローカル代替を掲げる無料アプリとして話題で、171ポイントの反響がありました。手元でファイルを操作する狙い、メモリ要件、Hacker Newsでの比較が読み取れますが、速度や品質の実測値は素材にはありません。
Hobは、ChatGPTやClaudeのローカル代替を掲げる無料アプリとして話題で、171ポイントの反響がありました。手元でファイルを操作する狙い、メモリ要件、Hacker Newsでの比較が読み取れますが、速度や品質の実測値は素材にはありません。
AIコーディングエージェントが「使える」から「制御できる」へ移っています。6原則と28実践、評価基準、長文脈や安全性の課題が並び、Hacker Newsでは利用者のAI実践を診断する試みも話題です。記事では、評価と運用設計の要点を整理します。
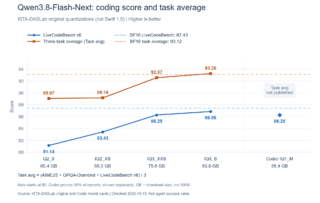
Strataのローカル推論で、RTX 5060 Ti 16GB環境の3種類の量子化の生成速度中央値が65.55、51.30、42.45トークン/秒と報告されました。Qwen 3.8 Flash Nextを使ったLG TVのroot試行やSTRATA-Benchも話題です。
OpenClawはセルフホストのAIエージェント基盤として、v2026.5.12の設計図と導入手順が確認できます。評価フレームワークの話題はあるものの、今回の素材に成功率や推論速度の数値はありません。ゲートウェイ、タスク台帳、メモリ、メディア、設定の全体像がわかります。
AIコーディングの文脈ウィンドウを、ガベージコレクションやRust製ツールで整理する動きが続いています。8192トークン予算で約3200トークンに絞る実例や40%削減の報告から、推論の質とコストの両立が課題だとわかります。
NVIDIAが音声aiモデルNemotron 3.5 Transcribeを公開しました。最適化NIMでは1枚のGPUで毎秒2,238秒分の音声を処理できるとされます。公開版の速度差やローカル実行の注意点を読み解きます。
CUDA MoE kernelの融合で、prefill速度が最大17.2%伸びたと報告された。カーネル起動やGPU同期を減らし、段階ごとに分ける設計が鍵になる。MoE推論の高速化は、メモリ往復や移植性まで含む話だとわかる。
RTX 3090は2026年も検証が続きます。最新素材では5090 D比63.25%の総合性能、PassMark17758件、350Wと3スロットの設置条件が確認できます。AI推論のローカル実行では、実測の厚みと物理制約の両面が重要です。
ai(AI)エージェントのHermesは、7週間でGitHubスター95,600を超えました。今回は自己改善より、信頼評価に焦点を移します。12項目や16次元のスコアカード、敵対的圧力での検証を追います。設計と評価の距離が見えます。
GrokBotはxAIのAIエージェントとして、開発者向けの基盤に組み込まれつつあります。今回はGrok Buildというエージェントの土台と、ベータ段階で残る課題を整理します。接続、設定、推論の部品がどう揃い、どこが測れていないかがわかります。
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS