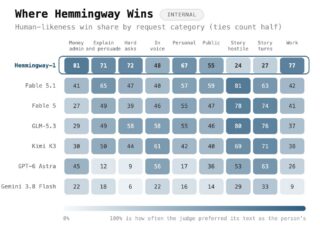
Hemmingway-1.5はQwen 27Bの文章特化モデルで、AI検知器を90%通過するとされています。人間は86%、前世代は7%で、書き味と検知回避が焦点です。ローカル実行や独自ベンチの注意点もわかります。
Hemmingway-1.5はQwen 27Bの文章特化モデルで、AI検知器を90%通過するとされています。人間は86%、前世代は7%で、書き味と検知回避が焦点です。ローカル実行や独自ベンチの注意点もわかります。
GitHub Copilotは、コード補完からエージェント中心の開発基盤へ刷新されました。Fusion MaxはOpus 5.5 Maxと2点以内の差で、コスト半分、時間40%短縮とされています。本記事では、その中身と制約を整理します。
OpenAIがGoogleのTPU購入を検討していると報じられました。Nvidia依存を減らす動きですが、金額や数量は未確認です。推論コストとaiチップ市場への影響、TPU調達とNvidia市場への波及を整理します。
Claude Opus 5.5がProgramBenchで18.5%を解きました。AnthropicのベンチではTerminal-Bench 4.0で66.4%を記録し、推論やエージェント性能も伸びています。aiニュースとして、速度・価格・比較の要点をまとめます。
Gemini Sparkの直接情報は乏しいが、Google AIの評価基盤が鍵です。適応型ルーブリックや本番ログ、計算指標でエージェントを測る入口が見えます。24/7運用では、hacker的な検証と指標設計が実務の分かれ目になります。素材から読み解きます。
HobがGPT-OSSを載せたローカルAIとしてHacker Newsで話題です。172ポイントを集め、プライバシーとオフラインが軸です。ベンチマークの信頼が揺らぐ中、自分の環境で試す価値が問われています。

AIコーディングエージェントの評価が、小さな修正から丸ごと実装へ移っています。ProjDevBenchでは6エージェントの全体受容率は27.38%でした。評価の広がり、失敗の可視化、人の不在という課題がわかります。
llama.cppはローカル推論の基準として、M1 Maxでの5エンジン比較や量子化の品質・サイズ評価で注目されている。JVM単一JARの高速主張やObsidian連携も話題だが、条件違いのため単純な優劣は難しい。
Strata/Basaltの最適化で、Qwen3.8 Flash Nextの125B MoEがRTX 5080で動くという報告です。prefill(一括処理)約5500TPS、decode(生成)ピーク275TPSとされ、実用性が一段上がりました。RAMや量子化の制約も扱います。
OpenClawは、チャットアプリとAIエージェントをつなぐ自前運用の基盤です。今回の素材では、タスク台帳やメモリ分割、評価基盤の存在が読み取れますが、具体的な成功数値や推論速度は示されていません。設計図と評価の輪郭がわかります。
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS