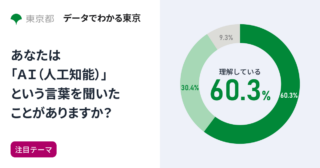
東京都の1万人調査で、AI認知度は約9割・私的利用は約4割、行政サービスへの肯定も約8割に達しました。一方で情報の真偽確認をしない人は3人に1人。OpenAIはティーン向けにAIを心の支えから教育ツールへ見直し、普及の先で「付き合い方」の調整が始まっています。
東京都の1万人調査で、AI認知度は約9割・私的利用は約4割、行政サービスへの肯定も約8割に達しました。一方で情報の真偽確認をしない人は3人に1人。OpenAIはティーン向けにAIを心の支えから教育ツールへ見直し、普及の先で「付き合い方」の調整が始まっています。
ISTA-DASLabがDeepSeek-V4.1-Flash-1017の非均一量子化「GSQ-RCO」を公開。重みを1.75〜2.25ビットまで圧縮し、Strata環境では12GB VRAMのGPU1枚での動作をうたいます。一方でllama.cpp非対応やARCベンチ未解決など、実用への課題も見えてきました。
NVIDIAがGemma 4ベースの小型モデル「Nemotron 3.5 Bolt E4B 4GB」を公開しました。約4GBのメモリで動き、先行モデル比で品質は平均約40%向上、出力トークンは最大約80%削減です。簡潔さ重視の設計とDFlashとの併用で、ローカル音声アシスタントの現実味を高めています。
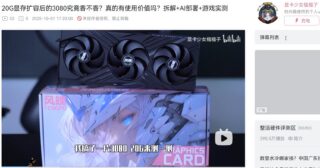
NVIDIA未発売のRTX 3080 20GB改造カードが中国で登場し、AI向け性能制限を解除するツールでの動作も確認されました。2枚構成の実測でprefillが+20%改善、decodeは0%。規格外カードとコミュニティ製アンロックの組み合わせが注目されています。
Intelの公式トップページが「Intel Inside – Built for AI」を掲げ、AI向けの姿勢を前面に出しています。1971年の4004以降、PC市場を支え、2024年には売上世界第3位の半導体メーカーです。一方、今回の素材からはAI性能の新たな実測値は見つからず、スローガンと実測の距離が見どころです。
脱獄PS5でllama.cppを動かすPS5LMの追跡記事です。GPU活用ではQwen3.5 0.8Bで約207トークン/秒、9Bで55トークン/秒、27Bでも約20トークン/秒の実測が報告されました。llama.cpp本体を移植する方式の強みと、削除リスク・コスパ論争も解説します。
VRAM 8GBのノートGPUで35Bモデルを動かすMoEオフロード手法が注目されています。MoEは推論で動く部分が約3Bと少なく、待機エキスパートをRAMへ置けばVRAMの壁を越えられます。スマホ向けの拡張レイヤー投稿や実践ガイドも出てきました。
「AIについていけない」という感覚が、調査の数字で裏づけられつつあります。AI進展に不安との回答は8割、技術を完全に制御できていると感じる人は10%です。一方でOpenAI自身も未成年の依存防止機能や、AIに気づかせないテスト手法を開発しており、作る側が制御に苦心しています。
日本の生成AI個人利用率は26.7%と米中を大きく下回り、71.3%がAIに不安を感じています。ついていけない原因は能力不足ではなく完璧主義や比較疲れなどの心理ブレーキと分析され、一方で先端のOpenAIもAIの制御に工夫を重ねています。流れの先も試行錯誤の途上であることがわかります。
ジェイルブレイクしたPS5でllama.cppを動かす「PS5LM」が話題です。Vulkan経由でGPUを使うネイティブ実行によりRAMは11.4GiBへ拡大し、小型モデルで最大124トークン/秒を達成。実測値と制約、27Bモデルへの目標を整理します。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS