Hacker Newsで、古いTesla P100を2枚使いQwen3.8-27Bを約60tpsで動かした報告が話題に。V100向けにはソフト復号のNVFP4版も登場し、17.6GBの重みを2枚に分割して動きます。旧GPUで新モデルを動かすローカル推論の実例を整理しました。
Hacker Newsで、古いTesla P100を2枚使いQwen3.8-27Bを約60tpsで動かした報告が話題に。V100向けにはソフト復号のNVFP4版も登場し、17.6GBの重みを2枚に分割して動きます。旧GPUで新モデルを動かすローカル推論の実例を整理しました。
xAIがGrok Botの公式発表を公開し、社内で実際に回っていた仕事の例を示しました。営業ボットのCRM更新、Gmailの請求書処理、バグ修正を別ボットへ引き継ぐ多段階連携などが挙げられています。ベータ版はSuperGrokとCursorの各プランで利用でき、本稿で発表の新情報を整理します。
Dotsシリーズの本体LLM「dots.llm1」の技術報告がarXivに公開されました。MoE構造でエキスパート128個+共有2個を備え、マルチGPUのエキスパート並列でよくスケールします。素材に具体的なベンチマーク数値はなく、実測検証が今後の課題です。
中国でRTX 5090を解体し、AIサーバー向けに組み直す工房の映像が話題です。GPUとGDDR7メモリを別基板に載せ替える作業が大規模に行われており、輸出規制で絞られた5090D(2375 AI TOPS)より標準版(3352 AI TOPS)が狙われたと報じられています。
買い占めで市場から消えたRTX 5090で、ローカルLLM推論の実測が相次いで公開されています。Qwenモデルでプロンプト処理約1万トークン/秒、27BモデルはMTP高速化で最高67.87トークン/秒を記録。エンジンと設定の選択が性能を左右する一方、カード価格は定価の3倍超が続いています。
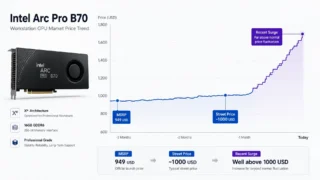
IntelのワークステーションGPU「Arc Pro B70」が1か月足らずで最大48%値上げし、実売2000ドル目前となっています。米国30%、欧州26%、韓国48%と地域差があり、32GB VRAMで推論向けに人気だった「1GB当たりのコスパ」優位が縮まっています。
llama.cppのMoEオフロードの仕組みを解説する記事が登場しました。トークンごとに一部だけ動くMoEの性質を生かし、層の一部をRAMに置く指定と、必要なエキスパートをディスクから先回りで読むストリーミングが鍵です。ある実装では約2倍の速度向上が報告されています。
自作LLM推論エンジンの挑戦が多様化し、ブラウザ内で量子化モデルを動かす試みや、純Python+NumPyだけの実装が登場しています。一方で期待200に対し20トークン/秒しか出ない壁や「llama.cppを使うべき」との声もあり、学習手段としての価値と実用の壁が同時に見えてきます。
AIにコードを書かせて自作推論エンジンを作る試みが広がっています。ブラウザ内で量子化モデルを動かした報告がある一方、トークナイザのデバッグなどで挫折する声も目立ちます。200行のPythonで作る例やAPI料金の実例から、自作の価値と限界が見えてきます。
Metaの個人AIエージェント「Muse」は、メール送信や購入の前に人間の承認を求め、アプリを閉じても作業を続ける設計です。読み書きを分ける権限システムや使い捨てカード決済など「任せるための仕組み」がそろい、実使用のレビューも出てきました。
2026.11.04
続・NVIDIA:Blackwellが推論と接続を変える
2026.11.04
続・Gufoの最新はStrix Haloで品質と速度を両立
2026.11.03
続・Hermes追跡(15):ベンチマークと自己進化ループ
RECENT COMMENTS