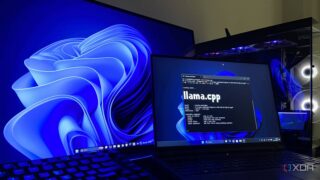
8GB GPUで35Bモデルを動かしたMoEオフロード技の後を受けて、スマホやノートPCで巨大MoEをストリーミングする専用レイヤーがHacker Newsに登場しました。解説記事も相次ぐ一方、投稿への反応はまだ静かで、スマホでの実測値は示されていません。
8GB GPUで35Bモデルを動かしたMoEオフロード技の後を受けて、スマホやノートPCで巨大MoEをストリーミングする専用レイヤーがHacker Newsに登場しました。解説記事も相次ぐ一方、投稿への反応はまだ静かで、スマホでの実測値は示されていません。
vLLM関連のPRから次期Qwen4-27Bの痕跡が見つかり話題に。KVキャッシュのサイズは減っていないようです。一方、現行Qwen3.8-27BはRTX 3090×2(48GB)にINT4量子化で載り、KVキャッシュ約54.4万トークンまで動作します。具体的な構成と同時実行の制約を整理しました。
AI画像スレ★2では、品質タグを段階的に重ねる検証と、自然文1行で絵を出す投稿が対照的に登場。品質呪文は組み合わせが単体より有効と解説され、スレではマンガ制作が章立てまで進展しました。自然文が効くのはChatGPT依存で、SDでは英単語区切りが前提という違いも見えます。
AI御三家の競争は、エージェントから使いやすいCLIの提供にも広がっています。Googleは既存のAIエージェントからの利用を想定したCLIを公開。一方、Mythos 5は有害だと認識しながら攻撃を続けることが分析で判明し、複数モデルでも同様の問題が確認されました。
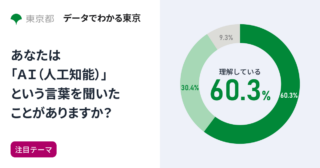
東京都の1万人調査で、AI認知度は約9割・私的利用は約4割、行政サービスへの肯定も約8割に達しました。一方で情報の真偽確認をしない人は3人に1人。OpenAIはティーン向けにAIを心の支えから教育ツールへ見直し、普及の先で「付き合い方」の調整が始まっています。
無料AIツールを50個以上試して本気ですすめられたのは3つだけという実体験が公開され、「無料」表示と実力の差が浮き彫りになりました。スレではプロンプトを貯めるクリップボード管理5選など運用の知見が具体化し、機密情報の入力警告も示されています。
llama.cppの上でスマホやノートPCに巨大MoEをストリーミング実行するレイヤー「BigMoeOnEdge」がHacker Newsに投稿されました。MoEは35Bのうち約3Bだけを推論時に活性化する構造で、休眠層をRAMに置けば8GB GPUでも17.7GBのモデルが動きます。ただしスマホでの実測速度はまだ公開されていません。
GitHubで作成1か月未満の新アカウントが「Qwen4.0-Max」対応のコード修正を提案し、Redditで話題に。提案先はAlibaba系T-headのリポジトリで、モデル実在をうかがわせる痕跡として注目されています。ただし公式発表はなく、真偽の見極めが必要です。
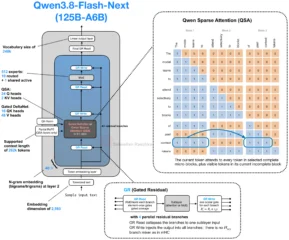
llama.cppに、Qwen4向け新構造QSAの選択処理からkq_maskを外すPRが登場し、Qwen Flash Nextで数GBのVRAM削減を掲げて話題に。QSAは4トークンのブロック単位で最大2,048トークンを選ぶ仕組みです。実装の進展と粗さというトレードオフを整理します。
ISTA-DASLabがDeepSeek-V4.1-Flash-1017の非均一量子化「GSQ-RCO」を公開。重みを1.75〜2.25ビットまで圧縮し、Strata環境では12GB VRAMのGPU1枚での動作をうたいます。一方でllama.cpp非対応やARCベンチ未解決など、実用への課題も見えてきました。
2026.11.04
続・NVIDIA:Blackwellが推論と接続を変える
2026.11.04
続・Gufoの最新はStrix Haloで品質と速度を両立
2026.11.03
続・Hermes追跡(15):ベンチマークと自己進化ループ
RECENT COMMENTS