748Bパラメータの巨大モデルが、2千ユーロの中古PCで動き出しました。前回の記事では、ハッカー系タスクのベンチマークでDeepSeek FlashがSolを上回った話をお伝えしました。その後、「自宅の機材でどこまで動くのか」というローカル推論の挑戦が話題になっています。ポイントは、動いたという事実 […]
748Bパラメータの巨大モデルが、2千ユーロの中古PCで動き出しました。前回の記事では、ハッカー系タスクのベンチマークでDeepSeek FlashがSolを上回った話をお伝えしました。その後、「自宅の機材でどこまで動くのか」というローカル推論の挑戦が話題になっています。ポイントは、動いたという事実 […]
スマートフォン1台で、350億パラメータ級のモデルが実用速度で動き始めています。Redditのr/LocalLLaMAで話題なのは、OpenBMBが公開したMiniCPM-V 4.7の技術解説です。入力に応じて一部の専門家ネットワークだけを動かすMoE方式の35B-A3Bモデルです。その振り分けを一 […]
テレビの下に置いたゲーム機が、そのままAIサーバーになる。そんな光景が実際に動き始めました。舞台はジャイルブレイク(本体の制限を解除する改造)済みのPS5です。ローカルで大規模言語モデルを動かす定番ソフトllama.cppを、PS5で動かすオープンソースプロジェクト。それが「PS5LM」です。開発者 […]
VRAM12GBのグラフィックボード1枚で、1250億パラメータのモデルが動く——。ローカル推論エンジン「Strata」をめぐり、そんな報告が相次いでいます。開発者Niko1221氏によるオープンソースのこのプロジェクトは、Qwen3.8-Flash-Next 125Bという大型のMoEモデルを、1 […]
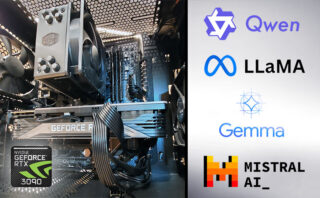
「5年前のグラボが、AIブームで再び争奪戦に」。今、海外の自作コミュニティでNVIDIAのRTX 3090がにわかに盛り上がっています。ハッカー寄りのユーザーが集うReddit(r/LocalLLaMA)には「3090への熱狂を警告するあの投稿の意味が、ようやく分かった」という書き込みが上がりました […]
「週間上限を燃やし尽くす前に、止めたい」。Hacker Newsに投稿された小さなツール「Peras」は、Claude CodeとCodexの使用を、上限を消費し切る前に一時停止するというものでした[1]。Claude Codeには5時間のセッション制限と週間上限という二重の使用制限があります。熱心 […]
1枚約11,400ドルのGPUが、300万枚単位で動き出しました。10月20日のロイター報道によると、中国巨大IT3社がNVIDIAのワークステーション向けGPU「RTX PRO 5500」を合計300万枚超発注したといいます[5]。発注したのは、ByteDance(バイトダンス)、Alibaba( […]
1枚のGPUで巨大MoEモデルを快適に動かしたい——。ローカルでAIモデルを走らせるコミュニティの共通の願いに、量子化で答える研究が話題です。Redditのr/LocalLLaMAに投稿されたのは、推論システム「Specter」を提案する論文です[1]。量子化とは、モデル内部の数値の精度を下げてサイ […]
数カ月かかる大規模なコード改修を、AIが数週間で終わらせた——。GoogleのGeminiを使った実例が報告され、話題になっています。前回は、エージェントの評価を繰り返しても見えてくる品質の壁を取り上げました。今回はその後の動きとして、実戦の大規模開発で何が起きているのかを追います。 いちばん具体的 […]
「モデルの中身を変えずに、生成を3倍以上速める。」そんな手法の最新版「EAGLE-4」が公開され、ローカルLLMコミュニティで話題になっています[1]。EAGLE-4は、EAGLEファミリーの最新世代です[2]。正式名称は「Extrapolation Algorithm for Greater La […]
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS