Qwen3.8 27Bの低量子化で落ちた精度を、SSDから補助モデルを動かして戻す試みが話題です。4kトークン超の長文脈なら速度の低下もないと報告されています。量子化と推論設定の最新動向を整理しました。
Qwen3.8 27Bの低量子化で落ちた精度を、SSDから補助モデルを動かして戻す試みが話題です。4kトークン超の長文脈なら速度の低下もないと報告されています。量子化と推論設定の最新動向を整理しました。
AIエージェントの安全性をめぐり、生成コードを動かす実行環境の隔離が注目されています。gVisorやFirecracker、WASMなどの候補が比べられ始め、端末内で完結させる動きも見えます。安全と速さの両立が課題です。
Qwen3.8 Flash Nextを巡り、速度と精度を両立させる工夫が話題です。ローカルでは27BモデルがGPU2枚で約60tok/s、ベンチでは53tok/sという報告があります。評価データの欠落もあり、数字の背景にある条件が結果を左右します。
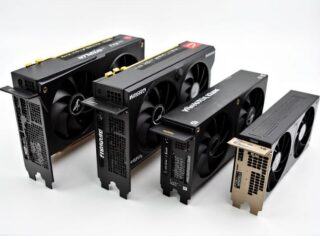
ローカルAI推論では、RTX 50系が32Bモデルで最大213 tokens/secを出す一方、70B超はVRAM不足が壁になります。選定の鍵は計算性能の数字より、VRAM容量とメモリ帯域、CUDAの代替の有無です。
AIエージェントをチャットから動かすOpenClawのv2026.5.12では、タスク台帳やメディア・memoryの分離が細かくなりました。評価基盤の名前も増えていますが、具体スコアはまだありません。接続から記録・評価への流れを整理します。
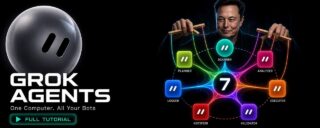
xAIのGrokBotの核心は、派手なモデル更新ではなく1アカウントで共有するクラウドPCの設計です。ボット間でファイルやログインが共有されるため、チームでは既定で有効、企業では管理者の設定が重要になります。承認停止や外部権限の取り消しまでが一続きの運用です。
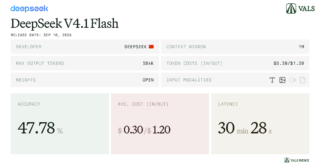
Vals AIの多段サイバー攻撃タスクで、DeepSeek V4.1 Flash 1017がGPT 6 Solを上回りました。総合スコア57.86%で公開モデル1位、1テスト0.30ドルと安く速い点も目立ちます。ただし単発タスクの結果であり、最初の返答までの遅さには注意が必要です。
Hermesの話題は三層構造などから音声接続へ移った。VoiceManagerは1本のWebSocketで低遅延音声を実現し、Hermes Agentは11種類の音声合成に対応。ただし実測遅延の数値はまだ出ていない。
llama.cppのCohere対応が視覚エンコーダまで広がりました。North Mini Codeは総30B・アクティブ3BのMoEで、ローカル実行の道が開いたと報告されています。ただし速度や電力の実測値はまだありません。
AI音声合成dots.ttsが、連続表現・音声編集・低遅延の数値を更新しました。Seed-TTS-EvalのWERや初音遅延85/54ms、編集ベンチdoteBenchを示しています。ローカル環境での実測情報はまだ不足しています。
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS