GPU1枚で、大型のAIモデルを丸ごと動かす──そんな報告がRedditで話題になっています。投稿先はローカルLLM愛好者のコミュニティr/LocalLLaMAです。ローカルLLMとは、クラウドに頼らず自分のPCで動かすAIモデルのこと。主役はQwen3.8-Flash-Nextというモデルです。こ […]
GPU1枚で、大型のAIモデルを丸ごと動かす──そんな報告がRedditで話題になっています。投稿先はローカルLLM愛好者のコミュニティr/LocalLLaMAです。ローカルLLMとは、クラウドに頼らず自分のPCで動かすAIモデルのこと。主役はQwen3.8-Flash-Nextというモデルです。こ […]
30B級のMoEモデルが、16GBのGPUで動くようになっています。さらに、エキスパート(専門家ネットワーク)を事前にメモリへ載せない方向まで進んできました。ローカル推論の定番llama.cppを巡るMoE最適化は、いま「オフロード(GPUに載らない重みをCPU側へ移す方式)」から「ストリーミング」 […]
航空券の値下がりを、AIが24時間体制で見張って知らせる——そんな使い方が現実に近づいています。Googleは新エージェント「Gemini Spark」を、開発者向けイベント「I/O 2026」で発表しました[1]。仕組みはシンプルです。ユーザーが仕事を頼み、必要なアプリの利用を許可すると、Spar […]
AIに説明書を読ませ、別のAIに採点させると、何点になるのでしょうか。OpenClawをめぐる最新の動きは、この実験のような試みから始まっています。OpenClawは、自分のコンピュータ上で動くオープンソースのAIエージェント基盤です。前回の記事では、タスク台帳と評価軸で動きが見える側面を追いました […]
スキャンした文書を渡すと、文字の内容だけでなく「どこに何が書いてあるか」までJSONで返ってくる。そんな軽量OCRモデルが話題になっています。鍵を握るのは推論エンジンのvLLMです。推論とは、学習済みモデルが答えを生成する処理のこと。vLLMはその処理を高速化するオープンソース基盤です。リクエストを […]
30BクラスのMoEモデルが、16GBのGPUで動きます。そんな工夫が、ローカルAI推論の定番ツール・llama.cppで現実のものになっています。さらに今は、専門家の重みをディスクから“流し込む”方式まで登場しました[2]。VRAM(GPUのメモリ)節約の設定は以前お伝えしましたが、今回はその先の […]
AIエージェントを一度動かすのは、もう簡単な時代です。難しいのは、失敗したあとにどう立ち直らせるかです。ハッカーニュースでは「gVisorでエージェントをサンドボックス化し、テックリードを演じる」という投稿が話題になりました[2]。gVisorは、プログラムを外部に影響が及ばない隔離環境で動かす技術 […]
AIエージェントが、自分の設計図を毎日書き換え続ける——。オープンソースの「Hermes」では、そんな光景が現実になっています。前回の記事では、音声のやり取りでローカルのAIエージェントにつながる様子を追いました。今回はその後の展開として、注目が集まる「中身」に踏み込みます。テーマは内部構造と、自己 […]
「チャットを閉じても、AIは働き続ける」。そんな使い方が、2026年8月11日に現実になりました。xAIがベータ版として公開した「Grok Bot」は、質問に答えるだけの対話型AIではありません。こちらが離席している間も、複数ステップの仕事を最後まで進めてくれます。いわば「常時稼働型」のAIエージェ […]
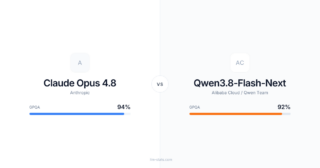
ローカルで動くモデルは、最上位のAPIモデルにどこまで迫れるのか。Redditのr/LocalLLaMAに投稿された検証が、その一つの答えです[1]。同じコーディングタスクを両者に解かせています。費用は0.32ドル対17.78ドル。約55倍の差です。それでいて完成度は69%対87%。この数字を順に読 […]
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS