自分のPCで動くオープンソースAIエージェント「OpenClaw」のその後。非営利財団が運営し有料サービスを持たない設計が改めて示された一方、有志の開発ドキュメントはAI2種の検証で「レビュー約4割短縮」の評価を得ました。最新版には6,844コミットが含まれます。
自分のPCで動くオープンソースAIエージェント「OpenClaw」のその後。非営利財団が運営し有料サービスを持たない設計が改めて示された一方、有志の開発ドキュメントはAI2種の検証で「レビュー約4割短縮」の評価を得ました。最新版には6,844コミットが含まれます。
AIエージェントを安全に動かす隔離環境づくりが、個人開発者の現場にも広がっています。Hacker Newsでは、カンバンボードでタスクを回しgVisorで囲う個人プロジェクトが話題に。企業の83%がエージェント導入を計画し、AI生成コードの45%がセキュリティテストに不合格となる中、隔離の選択肢は4つに整理されつつあります。
NousResearchのAIエージェント「Hermes」追跡の第3弾。前回の三層構造に続き、70以上のツールと28のツールセット、DockerやSSHなど隔離環境での実行、SQLiteでのセッション保持という実行基盤を整理。スター数9万5600の人気の一方、ベンチマークの具体値は素材からは確認できなかった。
GrokBot本体の直接情報は素材になかったものの、Grok 4.7の公式ドキュメントから開発者視点の最新動向が見えてきました。キャッシュ用の目印指定で実質料金が変わり、推論の暗号化保持が標準化。Fastは標準の2倍単価でCursorとGrok Build限定です。
Qwen3.8-27Bのローカル推論で、旧世代GPUでの実測報告が相次いでいます。Tesla P100×2枚のQ6_K量子化で約60tps、V100 32GBでは13万トークンのコンテキスト動作を確認。RTX 4090での4構成比較ではNInferとq27がわずか0.16%差という結果も出ました。
RTX 5060 Ti(16GB)でのローカルAI推論の実測検証が相次いでいます。8Bモデルを76トークン/秒で安定動作し、30人同時でもエラーゼロ。一方で30Bクラスは1枚では動かず、新モデル18個の比較でも既存モデルを超えたものはなかったと報告されています。
ローカル推論エンジンcapy-flash v0.7.1が公開され、125B MoEのQwen3.8-Flash-Nextが64GB RAMで動くようになりました。16GB GPU2枚で234tok/s、1枚でも121tok/s。27Bは16GB GPU1枚で動き、品質のトレードオフも報告されています。
文書解析AI「dots.ocr」のその後を追いました。2026年3月に1.5版が「dots.mocr」へ改名され、グラフや図解をSVGコードへ直接変換する新能力が加わっています。1.7Bの小型モデルのまま多言語解析の最高性能を保つ点と、評価上の留意点を解説します。
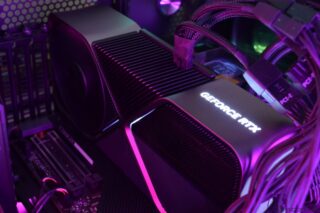
RTX 5090の16ピン電源コネクタの溶損報告が止まず、修理店には2日で8枚の溶損カードが届いた。消費電力は前世代の450Wから575Wへ増え、テスト中には613.5Wやケーブル175°Cの記録も。新規格でも防げない実態と、所有者が確認すべき点を整理します。
Recursiveが初のモデルFlintを公開。40BのMoEで1トークンあたり2.5Bだけ動かし、50B未満のMoEとしてコーディング系ベンチマークで上位になりました。M4 Proで125トークン/秒超の推論が可能な一方、denseの強豪には及ばない数値も見えます。
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS