Nvidia出資のFireworks AIが数週間で2回目となるセキュリティ侵害を顧客に通知しました。第三者クラウド経由で開発環境に到達され、請求情報や一部のデータセット、不完全なモデルに影響が及んだとされています。通知の中身と報道の要点をまとめます。
Nvidia出資のFireworks AIが数週間で2回目となるセキュリティ侵害を顧客に通知しました。第三者クラウド経由で開発環境に到達され、請求情報や一部のデータセット、不完全なモデルに影響が及んだとされています。通知の中身と報道の要点をまとめます。
[2026-11-18 更新] HalogenはStrix Halo向けローカル推論エンジンとして注目されますが、発表資料では詳細は明らかにされていません。FP4で125B MoEを96GiBに載せる方向と、128GB統合メモリのセットアップから位置づけを探ります。
NVIDIAがRTX 5080 24GBの中国向け投入を中止したと報じられました。3GB GDDR7チップが2GBチップの約3倍のコストになるためで、16GB版が残る見込みです。ローカルAI推論への影響と、噂の範囲を整理します。
UnslothがDynamic V3.1を公開し、Qwen3.8-27BやFlash系で同サイズ比10〜15%精度向上、トークン50%減を主張しています。AIローカル向け1-bit版やアプリ改善も進むが、Redditでは改善幅に疑問の声も出ています。
[2026-11-15 更新] RTX 3090は24GBのAI推論向けだけでなく、350Wや三スロットなど設置条件が問われるGPUです。Technical CityやNanoReview、Notebookcheckの資料から、ベンチマークの差と現実的な制約を整理します。
[2026-11-15 更新] Qwen4はAIの最新世代としてMaxプレビューが先行し、flashや27Bの行方が焦点です。ローカル向けの27Bは未公開で、100万トークンの入力や推論オプションを試せますが、実測TPSや必要VRAMは不明で、公開待ちが続きます。
llama.cppの切替高速化は、モデルの読み直しよりKV cacheの再利用へ移っています。2秒以内のスリープやキャッシュ再利用が話題ですが、–cache-ramの誤解やキャッシュ圧縮の速度低下が落とし穴です。構成とキャッシュ設計の重要性がわかります。
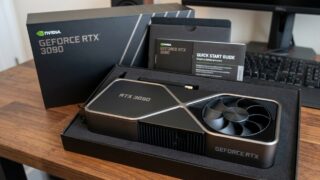
2026年時点のRTX 3090は、24GBのGDDR6Xと936GB/sの帯域幅を武器に、ローカルAIの推論や4Kゲームで注目されています。350Wや3スロットの制約は残りますが、flashのようなAIを含む中古市場での選び方が見えてきます。
Qwen3.8-27Bの重み9か所を書き換えた実験モデルです。GPQA Diamondで+4.3、LiveCodeBench v6で+13.0、思考トークンは27〜54%減ったと報告されています。対照実験と量子化の限界が要点です。
[2026-11-14 更新] Gufoは用途ごとに1モデルだけを選ぶ設計や拡張レジストリ、品質報告を打ち出しました。Strix Haloの128GiB統合メモリ向けに、速度だけでなく信頼性と運用性を詰める動きです。2台連携やWindowsポートは未統合のまま紹介されています。
2026.11.20
続・Gufo、拡張とRDMAでローカルAIを育てる
2026.11.19
ローカルLLM、快適さはモデルより帯域と量子化
2026.11.19
続・Meta Muse、無料AIエージェントとハッカー的な試行
RECENT COMMENTS