5chのAI画像スレでは、同じプロンプトでも編集や再実行で出力が揺れる試行が続いています。Metaのラベル義務や検出精度の話題と重なり、画像生成は透明性の実験場になっています。Xトレンドの語も確認でき、記事では境界の曖昧さを追っています。
5chのAI画像スレでは、同じプロンプトでも編集や再実行で出力が揺れる試行が続いています。Metaのラベル義務や検出精度の話題と重なり、画像生成は透明性の実験場になっています。Xトレンドの語も確認でき、記事では境界の曖昧さを追っています。
[2026-11-17 更新] AIモデルdots.llm1の続報では、総パラメータ142Bで1トークンごとに14Bを動かすMoE構造や、sliding_window 4096などのconfigが確認できます。ローカル推論に必要なVRAMやTPSは発表資料では明らかにされていません。
[2026-11-17 更新] 大手企業のAI導入率は88.7%に達し、話題は成果と評価へ移っています。企業ではROIや人材の課題が残り、個人はスレッドで変化の速さを共有しています。本記事は、導入の当たり前化と評価の遅れから「ついていけない」を読み解きます。
[2026-11-17 更新] 無料AI活用専用スレでは、目的・音声対応・登録要否の3軸でツールを選ぶ動きが広がっています。壁打ち型の質問術やクリップボード管理、予定済みタスクの無料開放も話題です。無料枠の制限を踏まえた実用的な使い方が、コミュニティで共有されています。
[2026-11-15 更新] Meta Museは2026年9月8日発表の個人向けAIエージェントで、旅行予約や決済まで狙うが、外部小売のブロックとタスク単価の非公開が日常利用を妨げる。レビューでは月25ドル節約という声と、監視や怖さへの警戒が並ぶ。実用性は安全設計より決済と価格の透明性で決まりそうです。
Redditでは、0.1B級の埋め込みモデルが8B級を置き換えたという報告が話題になりました。ローカルRAGでは推論の速さと検索品質のバランスが重要で、小モデルでも用途次第で有力です。ただし評価は検索指標に限られ、回答精度とは別です。
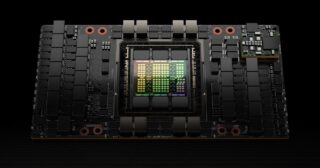
BlackwellがMLPerf Training v5.1で全項目最速となり、B200のmicrobenchmarkではメモリ遅延が58%減りました。AIの推論セッションでは、データのやり取りと次バージョンのFP4の精度が焦点になります。
OpenAIの仕様更新、行動規範比較、METRの加速評価、市場シェア変化が話題です。ChatGPTは日本で39.36ポイント下落し2位、AIの寄与は約80%と示唆されました。選び方が性能から運用・価値観へ移った状況が伝わります。
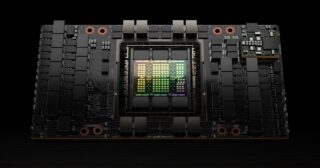
NVIDIAのBlackwellを巡り、MLPerfで全項目最速と報告されました。さらに論文ではB200がH200比で学習スループットが1.85倍、エネルギー効率が32%向上したと実測されています。AIの推論と学習で、FP4と省エネの差が焦点です。
Qwen3.8系の公開とローカル推論が同時に進み、Strataとllama.cppの速度差や27Bの評価と不満が話題です。API版の拡充やAIバブル関連語も加わり、実運用では速さと安定を自分の構成で測る必要があり、分かれ目が見えます。
2026.11.20
続・Gufo、拡張とRDMAでローカルAIを育てる
2026.11.19
ローカルLLM、快適さはモデルより帯域と量子化
2026.11.19
続・Meta Muse、無料AIエージェントとハッカー的な試行
RECENT COMMENTS