ThreadShelfの続報です。MCPサーバーは9ツールでObsidianのvaultを既定読み取り専用にし、削除はMCP外に限定します。Hacker Newsの注目度は小さく、AIバブル関連トレンドの中でローカル推論の安全な接続が進みます。
ThreadShelfの続報です。MCPサーバーは9ツールでObsidianのvaultを既定読み取り専用にし、削除はMCP外に限定します。Hacker Newsの注目度は小さく、AIバブル関連トレンドの中でローカル推論の安全な接続が進みます。
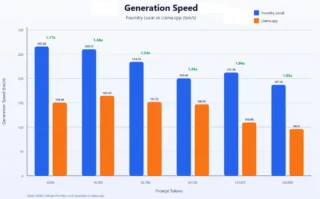
Foundry LocalはQwen3.8-27Bをローカルで動かし、GitHub Copilotに接続します。量子化で約18GB、24GBのGPUメモリで動作し、llama.cppより速いという報告があります。実用性と制約がわかります。
RTX 3090でDeepSeek Flashを動かす試みです。Delta推論エンジンv0.93は192GB RAMで41 tok/s、64GB RAMでも使えると報告されています。品質は99問で52問から57問に改善し、入口がRAMと量子化へと広がりました。
[2026-11-15 更新] llama.cpp v1.0は、ローカルAI推論のAPI安定化とmacOS向けネイティブアプリを同時に打ち出しました。RTX 3090では先読み推論で最大55%速くなったとの報告があり、互換性と速度の両立が焦点です。
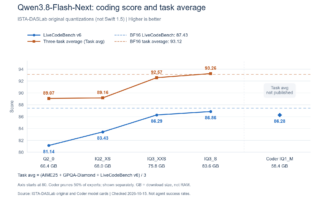
StrataでQwenの小型から大型まで試した結果、VRAMを超える構成でprefillとdecodeが伸びる分岐点が示されました。RTX 3060では35B以上のMoEで最大約2倍、RTX 5060 Tiでは軽い量子化が65.55トークン/秒です。
NVIDIAのBlackwellがMLPerf Training v5.1で全項目で最速を発表しました。H200比ではResNet-50が1.85倍、GPT-1.3Bが1.55倍、電力効率は32%改善しました。FP4と接続仕様からAI推論と学習の変化を解説します。
Qwen3.8 Flash-Nextのローカル推論で、RTX 5080と64GB RAMの構成が話題です。実測はエージェント作業で平均195.6トークン/秒、prefill約5700トークン/秒と報告されました。27Bの推定速度や不満もあり、構成とエンジン次第で評価が分かれています。
UnslothがQwen3.8-Flash-NextのGGUFをV3.1に更新し、15%高い精度をうたう。26.2Bトークンのベンチやengram容量、ローカル実行のRAM目安が話題です。XトレンドではChatGPTImages2.6やAI暴走も上がります。
UnslothがQwen3.8-Flash-NextのDynamic v3.1 GGUFを公開し、DeepSWEなどで10〜15%の精度向上を主張しました。125B MoEモデルを32GB以上のRAMでローカル推論できる点と、量子化の選択肢が注目されています。
CognitionがSWE-2 Flashを発表し、コーディングエージェントの推論速度を3倍に、価格を5分の1にしました。一方Appleは10-Kで、エージェントの未承認行動や情報操作を重大なリスクとして記述しました。性能と安全設計が同時に進む状況がうかがえます。
2026.11.20
続・Gufo、拡張とRDMAでローカルAIを育てる
2026.11.19
ローカルLLM、快適さはモデルより帯域と量子化
2026.11.19
続・Meta Muse、無料AIエージェントとハッカー的な試行
RECENT COMMENTS