OpenAIのSam Altman氏は2026年の株式公開を見送ると述べました。背景にはAIの安全・アライメントと政府・業界の協調があり、2027年の上場は未確定です。本記事では発言と周辺動向を整理します。
OpenAIのSam Altman氏は2026年の株式公開を見送ると述べました。背景にはAIの安全・アライメントと政府・業界の協調があり、2027年の上場は未確定です。本記事では発言と周辺動向を整理します。
StrataでAIモデルQwen3.8-Flash-Next 125Bを12GB GPUと64GB RAMで動かす話題が再燃しています。量子化IQ_3S GSQ RCOはBF16の99.0%、Unslothの新版は約15%良いとされます。構成と速度、注意点を整理します。
OpenAIはChatGPT Pro 200の利用枠縮小を撤回し、Pro各プランのWork/Codex枠を倍増したと報じられました。ただし倍率は未公開で、Dots枠は別建てのままです。撤回後の運用とUltrafast付きPro 500を整理します。
UnslothがQwen3.8-Flash-NextのDynamic V3.1 GGUFを公開し、GSQ-RCO比で10〜15%の精度向上を主張。26Bトークン超の検証や量子化切替が話題で、ローカル実行の目安も追います。
B200は実測でH100より最大57%速く、自前運用なら最大10倍安いと報告されました。推論はモデルやソフトウェアの成熟に左右され、FP4はNVFP4が前提です。仕様・価格・電力の落とし穴を追います。
Alibaba の Qwen4 は、本体完成前に設計図を公開する動きが目立ちます。125B MoE でアクティブ 6B、51B を DDR4 に退避し、ローカルで 21 tokens/sec とされています。推論設定と公開予定を整理します。
BlackwellがAI学習ベンチマークMLPerf Training v5.1で7モデル全項目の最速学習を掲げました。FP4/NVFP4とB200の実測から、学習速度と電力効率の差が見えます。推論を含む評価の中心が接続から学習へ動いています。
Revolutは約2,000人のエンジニア向けAIコーディングをZ.aiのGLMのローカル運用に切り替え、推論コストを約90%削減したと報じられました。56枚のB200で100万トークンあたり0.30ドルを実現し、速度改善も示しています。
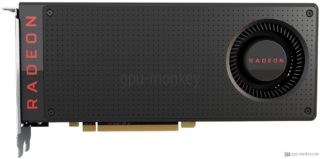
RedditでRX470のGPUを4基載せた試作PCIeカードが話題です。旧世代GPUの仕様はFP32 4.94TFLOPS、VRAM 4GBなどですが、推論速度の実測値は確認できません。AI・半導体関連株の動きと合わせて追跡します。
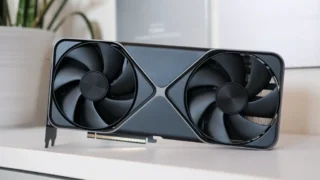
RTX 5090の話題が品薄からローカルAI推論へ移りました。Basalt 0.2.0は5090と5060 TiでQwen 3.8 Flash Nextを動かし、prefill 10K t/sと高速を示す一方、量子化で品質差が出ました。速度と品質、入手性が焦点です。
2026.11.20
続・Gufo、拡張とRDMAでローカルAIを育てる
2026.11.19
ローカルLLM、快適さはモデルより帯域と量子化
2026.11.19
続・Meta Muse、無料AIエージェントとハッカー的な試行
RECENT COMMENTS