StrataでQwenの小型から大型まで試した結果、VRAMを超える構成でprefillとdecodeが伸びる分岐点が示されました。RTX 3060では35B以上のMoEで最大約2倍、RTX 5060 Tiでは軽い量子化が65.55トークン/秒です。
StrataでQwenの小型から大型まで試した結果、VRAMを超える構成でprefillとdecodeが伸びる分岐点が示されました。RTX 3060では35B以上のMoEで最大約2倍、RTX 5060 Tiでは軽い量子化が65.55トークン/秒です。
NVIDIAのBlackwellがMLPerf Training v5.1で全項目で最速を発表しました。H200比ではResNet-50が1.85倍、GPT-1.3Bが1.55倍、電力効率は32%改善しました。FP4と接続仕様からAI推論と学習の変化を解説します。
Qwen3.8 Flash-Nextのローカル推論で、RTX 5080と64GB RAMの構成が話題です。実測はエージェント作業で平均195.6トークン/秒、prefill約5700トークン/秒と報告されました。27Bの推定速度や不満もあり、構成とエンジン次第で評価が分かれています。
UnslothがQwen3.8-Flash-NextのGGUFをV3.1に更新し、15%高い精度をうたう。26.2Bトークンのベンチやengram容量、ローカル実行のRAM目安が話題です。XトレンドではChatGPTImages2.6やAI暴走も上がります。
UnslothがQwen3.8-Flash-NextのDynamic v3.1 GGUFを公開し、DeepSWEなどで10〜15%の精度向上を主張しました。125B MoEモデルを32GB以上のRAMでローカル推論できる点と、量子化の選択肢が注目されています。
CognitionがSWE-2 Flashを発表し、コーディングエージェントの推論速度を3倍に、価格を5分の1にしました。一方Appleは10-Kで、エージェントの未承認行動や情報操作を重大なリスクとして記述しました。性能と安全設計が同時に進む状況がうかがえます。
OpenAIのSam Altman氏は2026年の株式公開を見送ると述べました。背景にはAIの安全・アライメントと政府・業界の協調があり、2027年の上場は未確定です。本記事では発言と周辺動向を整理します。
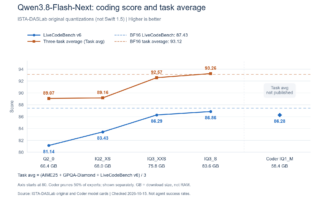
StrataでAIモデルQwen3.8-Flash-Next 125Bを12GB GPUと64GB RAMで動かす話題が再燃しています。量子化IQ_3S GSQ RCOはBF16の99.0%、Unslothの新版は約15%良いとされます。構成と速度、注意点を整理します。
OpenAIはChatGPT Pro 200の利用枠縮小を撤回し、Pro各プランのWork/Codex枠を倍増したと報じられました。ただし倍率は未公開で、Dots枠は別建てのままです。撤回後の運用とUltrafast付きPro 500を整理します。
UnslothがQwen3.8-Flash-NextのDynamic V3.1 GGUFを公開し、GSQ-RCO比で10〜15%の精度向上を主張。26Bトークン超の検証や量子化切替が話題で、ローカル実行の目安も追います。
2026.11.11
続・RTX 3090、2026年の中古で24GBとNVLinkが再評価される
2026.11.11
続・Qwen4、4種とFlashが示すローカル実行の行方
2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
RECENT COMMENTS