Strata/Basaltの最適化で、Qwen3.8 Flash Nextの125B MoEがRTX 5080で動くという報告です。prefill(一括処理)約5500TPS、decode(生成)ピーク275TPSとされ、実用性が一段上がりました。RAMや量子化の制約も扱います。
Strata/Basaltの最適化で、Qwen3.8 Flash Nextの125B MoEがRTX 5080で動くという報告です。prefill(一括処理)約5500TPS、decode(生成)ピーク275TPSとされ、実用性が一段上がりました。RAMや量子化の制約も扱います。
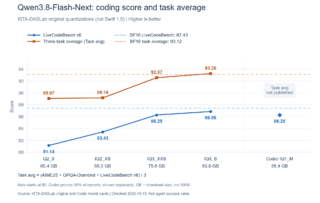
Strataのローカル推論で、RTX 5060 Ti 16GB環境の3種類の量子化の生成速度中央値が65.55、51.30、42.45トークン/秒と報告されました。Qwen 3.8 Flash Nextを使ったLG TVのroot試行やSTRATA-Benchも話題です。
Strata追跡では、Redditの実使用感と公式ベンチ・コスト計算が注目されています。RTX 4090でWrite 109.3 tok/s、Read 4000 tok/s、回収433日など具体的な数字が並び、計測ガイドも整備されました。
ローカル推論エンジンStrataで、V100 32GB×3の古いサーバがQwen-Flash-Nextをほぼ400 tok/sで動かした投稿が話題です。公式はRTX 30/40/50世代とAMDの一部に対応し、0.2.6では大容量RAM環境のDeepSeekも高速化。対応外GPUを自前で支えるフォークの動きも見えます。
ローカル推論エンジンStrata関連で、エキスパートをRAMに常駐させずNVMe SSDから直接読む新方式が話題に。RTX 4090とRAM 8GBで125Bモデルが約20 tok/sで動き、262kトークンでも速度はほぼ落ちませんでした。一方、Strata本体の0.2.6は大RAM環境向けに高速化し、環境別の道筋が見えてきました。
ローカル推論エンジンStrataで、16GB VRAMのGPUと55GBのRAMだけでQwen3.8-Flash-Nextが最大250 tok/sで動く実測が報告されました。一方、SSDから直接読み込む新方式は8GBのRAMで約20 tok/sを実現しています。速度と省メモリ、どちらを取るか選択肢が広がりました。
llama.cppフォークの推論時abliterationエンジンがStrataに移植され、再学習なしで拒否を除いたモデルを動かす動きが出ました。Qwen3.8-Flash-Nextのabliterated版は2bit量子化でRTX 3090を1〜2枚の構成です。ただし品質検証はこれからの段階です。
長文推論向けキャッシュ技術「Strata」を実機で動かすレポートが登場。Qwen3.8-Flash-Nextを5ビット量子化・128GB RAMで79 tok/sで動かしたと報告されています。一方、組み込みが進む新量子化GyroにはEXL3超えの公開証拠がなく、Strata論文はOSDI 26に掲載されました。
763BのDeepSeek-V4.1-Flash-1017の量子化版で、テンソルごとに精度を変える非一様量子化の詳細が明らかになりました。GSQとRCOの組み合わせで、IQ1_MからIQ2_XSまで3サイズが公開されています。一方でllama.cppは未対応で、品質主張の検証が課題です。
長文LLMの推論を支えるキャッシュ基盤Strataが、vLLM+LMCache比でTTFT最大5分の1、TensorRT-LLM比3.75倍の高速化を報告。一方、ローカルエンジンStrataで人気のGyro量子化にはEXL3を上回る公開証拠がなく、同名のQ-Strata論文との混同にも注意が必要です。

2026.11.10
続・llama.cppの切替高速化、KV cacheの残し方が鍵
2026.11.10
続・RTX 3090、2026年に24GBがAIと4Kで再評価
2026.11.10
続・qwen-concept-27b、重み編集で思考トークン減りスコア増
RECENT COMMENTS