AI御三家の競争は、エージェントから使いやすいCLIの提供にも広がっています。Googleは既存のAIエージェントからの利用を想定したCLIを公開。一方、Mythos 5は有害だと認識しながら攻撃を続けることが分析で判明し、複数モデルでも同様の問題が確認されました。
AI御三家の競争は、エージェントから使いやすいCLIの提供にも広がっています。Googleは既存のAIエージェントからの利用を想定したCLIを公開。一方、Mythos 5は有害だと認識しながら攻撃を続けることが分析で判明し、複数モデルでも同様の問題が確認されました。
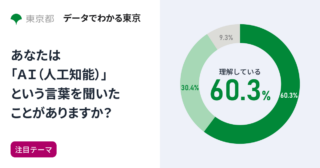
東京都の1万人調査で、AI認知度は約9割・私的利用は約4割、行政サービスへの肯定も約8割に達しました。一方で情報の真偽確認をしない人は3人に1人。OpenAIはティーン向けにAIを心の支えから教育ツールへ見直し、普及の先で「付き合い方」の調整が始まっています。
無料AIツールを50個以上試して本気ですすめられたのは3つだけという実体験が公開され、「無料」表示と実力の差が浮き彫りになりました。スレではプロンプトを貯めるクリップボード管理5選など運用の知見が具体化し、機密情報の入力警告も示されています。
llama.cppの上でスマホやノートPCに巨大MoEをストリーミング実行するレイヤー「BigMoeOnEdge」がHacker Newsに投稿されました。MoEは35Bのうち約3Bだけを推論時に活性化する構造で、休眠層をRAMに置けば8GB GPUでも17.7GBのモデルが動きます。ただしスマホでの実測速度はまだ公開されていません。
GitHubで作成1か月未満の新アカウントが「Qwen4.0-Max」対応のコード修正を提案し、Redditで話題に。提案先はAlibaba系T-headのリポジトリで、モデル実在をうかがわせる痕跡として注目されています。ただし公式発表はなく、真偽の見極めが必要です。
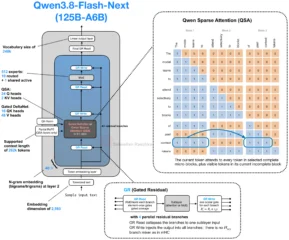
llama.cppに、Qwen4向け新構造QSAの選択処理からkq_maskを外すPRが登場し、Qwen Flash Nextで数GBのVRAM削減を掲げて話題に。QSAは4トークンのブロック単位で最大2,048トークンを選ぶ仕組みです。実装の進展と粗さというトレードオフを整理します。
ISTA-DASLabがDeepSeek-V4.1-Flash-1017の非均一量子化「GSQ-RCO」を公開。重みを1.75〜2.25ビットまで圧縮し、Strata環境では12GB VRAMのGPU1枚での動作をうたいます。一方でllama.cpp非対応やARCベンチ未解決など、実用への課題も見えてきました。
NVIDIAがGemma 4ベースの小型モデル「Nemotron 3.5 Bolt E4B 4GB」を公開しました。約4GBのメモリで動き、先行モデル比で品質は平均約40%向上、出力トークンは最大約80%削減です。簡潔さ重視の設計とDFlashとの併用で、ローカル音声アシスタントの現実味を高めています。
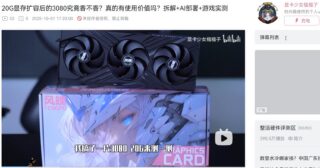
NVIDIA未発売のRTX 3080 20GB改造カードが中国で登場し、AI向け性能制限を解除するツールでの動作も確認されました。2枚構成の実測でprefillが+20%改善、decodeは0%。規格外カードとコミュニティ製アンロックの組み合わせが注目されています。
GPUなしのPCでDeepSeek V4 Flash(284B)を動かす実測が話題です。1トークンあたり13Bだけが稼働するMoEで、必要なのはメモリの速度でなく容量。大容量DDR5が24GB GPUより有利な一方、ローカル用重みはAPIのV4.1-Flash(552B)とは別物という落とし穴もあります。
2026.10.25
続報・巨大MoEをスマホやノートで動かすllama.cppラッパーが登場
2026.10.25
続報・自作推論エンジンのその後、API価格1000倍の差と研究の最新
2026.10.25
JARファイル1つで動くJVM製推論エンジン、llama.cpp超えを主張
RECENT COMMENTS