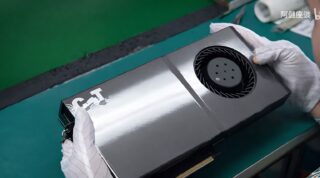
生産終了の噂のRTX 5090が、中国の工房に数百枚並ぶ様子が公開されました。技術者がGPUチップと32GBのGDDR7メモリを剥がし、AIサーバー向けの独自基板に組み替えています。輸出規制下でも流入が続く背景が注目されています。
生産終了の噂のRTX 5090が、中国の工房に数百枚並ぶ様子が公開されました。技術者がGPUチップと32GBのGDDR7メモリを剥がし、AIサーバー向けの独自基板に組み替えています。輸出規制下でも流入が続く背景が注目されています。
Redditで、ローカル動作のQwen3.8 Flash Nextによるモーショングラフィックス制作が話題です。Strix Haloと量子化モデルで、クラウド巨大モデルと同じフレームワークの動画を完成させました。ただし複数回の調整が必要で、速度の実測はまだありません。
Qwen3.8-27Bを古いTesla P100 2枚で約60tpsで動かす報告に、動作環境の詳細が判明しました。一方Redditでは、同シリーズをベースにBlender用3Dモデル生成を強化したfinetuneを求める声が登場。テキスト推論は進化を続ける一方、3D生成に応えるモデルはまだ見つかっていない実情がわかります。
llama.cppのMoEオフロードをめぐり、スマホやノートPCで巨大MoEを動かすラッパーがHacker Newsに投稿されました。Qwen3-235B-A22Bは総235Bのうち約22Bだけが動くため、16GBのGPUでも動かせます。ただしラッパー自体の実測値はまだありません。
自作推論エンジンへの挑戦が続き、手法のバイブコーディングは学術論文でも扱われるようになりました。GPT-4は出力1000トークン0.06ドル、小型モデルは100万トークン0.06ドルと価格差は1000倍。価格の動機、OOMやインスタンス共有の問題、研究の最新を追います。
JVM上で動く推論エンジンが、依存ライブラリなしのJARファイル1つでローカル推論ができ、llama.cppより速いと主張してHacker Newsに投稿されました。ただしコメントはなく、根拠数値も素材では未確認です。比較記事が乱立するローカル推論分野に、検証待ちの新顔が登場しました。
Metaの個人向けAIエージェントMuseは、無料枠に月額20ドルと100ドルのプランを用意し、広告を載せず取引手数料で稼ぐ方針を示しました。Stripe連携の決済保護や11社の提携、10月の新モデルMuse Wonder発表など動きが相次いでいます。一方でレビューには「摩擦」を指す言葉も現れました。
vLLM周辺で、27Bクラスを1枚のGPUで動かす試みが進んでいます。Qwen3.6-27Bは量子化とDFlashの草案検証で、256トークン出力・1〜4同時ストリームを合計33.7秒で処理。一方でVRAMだけでは速度は決まらず、次期Qwen4のKVキャッシュも減らないようです。
llama.cppの高速化フォークik_llama.cpp関連の動きが相次いでいます。MoE最適化を進めるフォークは6GBのRTX 2060で生成45〜48トークン/秒、28Kコンテキストでも37トークン/秒を報告。フォークが先行した機能や利用上の注意点、本体統合を見送る理由まで整理します。
アルトマン氏が、OpenAIの最強モデルはサイバー防御とバイオセキュリティが整うまで公開できないと明言。9月以降は減速や公開見送りの発言が相次ぐ一方、ChatGPT Adsの89市場展開など事業拡大も進んでいます。そのギャップから見えるものを整理します。
2026.11.01
続・Gemini Tasks、改名後の課金と安全の落とし穴
2026.11.01
Altman氏、AIの推論速度と安全を語る
2026.11.01
Ternary Bonsai 2、ローカル推論の壁を越えた
RECENT COMMENTS